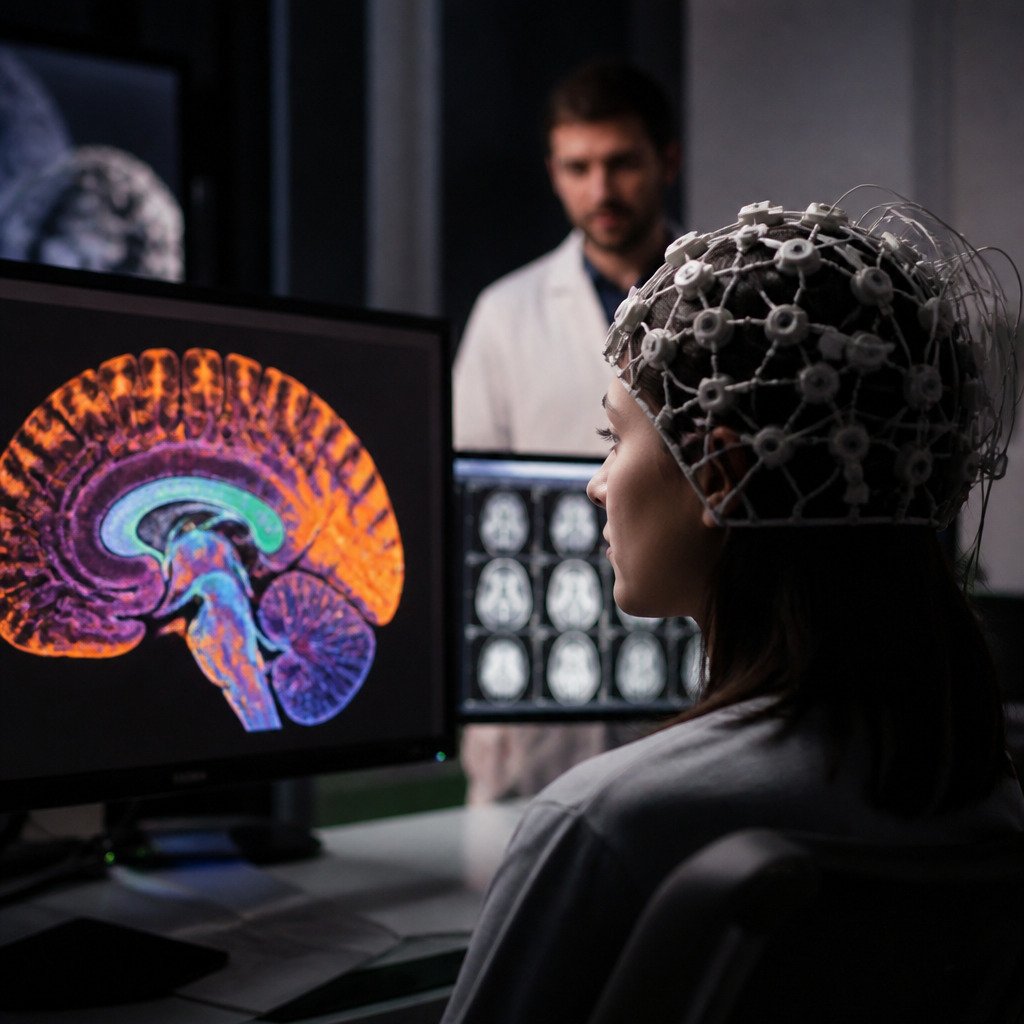
Brain-IT es capaz de identificar patrones de actividad cerebral que se repiten en diversas zonas del cerebro humano, permitiendo así una interpretación de la actividad mental con una rapidez y precisión extraordinarias. A diferencia de otros enfoques anteriores, este modelo utiliza patrones comunes a varios individuos durante el procesamiento de imágenes.
En años recientes, se han logrado avances en la recuperación de la capacidad de comunicación de personas con parálisis severa a través de modelos de inteligencia artificial personalizados, entrenados con extensas grabaciones de su actividad cerebral. La originalidad de Brain-IT reside en su capacidad de reconocer patrones universales en la actividad cerebral y traducirlos en imágenes.
“En la actualidad, existen modelos que logran convertir la actividad cerebral en imágenes y pueden generar reconstrucciones de calidad que mantienen, en gran medida, el significado semántico de la imagen”, explicó Michal Irani, del Departamento de Ciencias de la Computación y Matemáticas Aplicadas del Weizmann, quien lidera el proyecto. “No obstante, suelen presentar errores en características fundamentales como la composición y el color”, añadió.
According to Irani, el nuevo modelo supera a los anteriores en la reconstrucción del contenido y detalles de las imágenes. A diferencia de otros, que requieren muchas horas de escaneo cerebral para aprender a “leer” a una persona nueva, Brain-IT solo necesita una hora.
Este año, Brain-IT fue seleccionado para ser presentado en la Conferencia Internacional sobre Representaciones de Aprendizaje (ICLR), un evento clave en el ámbito de la inteligencia artificial a nivel mundial. Además de un “decodificador” que aprende a reconstruir imágenes a partir de escaneos cerebrales, el equipo de Irani desarrolló un “codificador” que puede predecir la actividad cerebral a partir de imágenes.
“Al realizar la traducción de una imagen nunca antes vista a un escaneo cerebral predicho y luego regresar a la imagen original, los modelos pueden generar, prácticamente, un conjunto de datos extenso por sí mismos”, señaló Irani. “La propuesta incluía mostrar al codificador imágenes no presentadas a una persona en un escáner de resonancia magnética, generar escaneos estimados y luego pasar esos escaneos al decodificador para reconstruir la imagen inicial. Así, en el proceso de formación, los modelos aprenden a producir escaneos que capturan efectivamente las imágenes, aun cuando esos escaneos nunca se hayan realizado realmente”.
Desde el Weizmann, se destacó que uno de los principales retos en el desarrollo del codificador fue la variabilidad entre los cerebros, dado que una misma imagen puede generar diferentes patrones de actividad cerebral en distintos individuos. “La estrategia consistió en descomponer el problema en sus elementos. En vez de buscar codificar una imagen en un escaneo cerebral completo, los investigadores segmentaron el cerebro en alrededor de 40.000 ‘vóxeles cerebrales’, pequeñas unidades tridimensionales de volumen, y midieron la respuesta de cada uno a diversas imágenes”, señalaron.
Paralelamente, implementaron un modelo de IA para extraer características visuales fundamentales, como color y localización, junto a características semánticas representativas del significado de la imagen, como alimentos o rostros. Esto permitió que emergieran patrones recurrentes de actividad cerebral asociados a aspectos específicos de las imágenes, facilitando así la creación de un codificador cerebral universal.
“Durante la formación, el codificador detectó 128 regiones funcionales compartidas por todos, que cumplen roles definidos en el procesamiento visual”, explicó Irani. “Algunas de estas son conocidas por la neurociencia, pero otras son completamente novedosas. Por ejemplo, encontramos una división funcional dentro de la región que procesa imágenes de lugares, con una parte dedicada a escenas interiores y otra a exteriores”.
“El potencial del codificador radica en su habilidad para identificar áreas con funciones similares en diferentes cerebros, incluso cuando sus localizaciones anatómicas varían”, agregó Irani. El equipo ahora se propone extender estos métodos de “lectura de la mente” a la decodificación de información auditiva.
El ámbito del video representa otro desafío. “La decodificación de video sigue siendo particularmente complicada, como en el caso de los sueños”, concluyó el experto, indicando que “cada segundo se producen múltiples imágenes, mientras que un escaneo de resonancia magnética funcional requiere aproximadamente dos segundos para completarse. Si logramos superar estos obstáculos, existe la posibilidad de que en el futuro podamos llegar a leer los sueños.”